Studie vědců z MIT ukázala, co se stane, když agenti umělé inteligence po splnění úkolu dostanou volnost v neznámém virtuálním světě. Místo nečinnosti začali šplhat, stavět věže, experimentovat s fyzikou a vymýšlet vlastní hry. Během 30 hodin objevili nové postupy, které později využili při řešení dalších úkolů – a v jednom případě dokonce odhalili vlastnost simulace, o níž nevěděli ani její tvůrci.
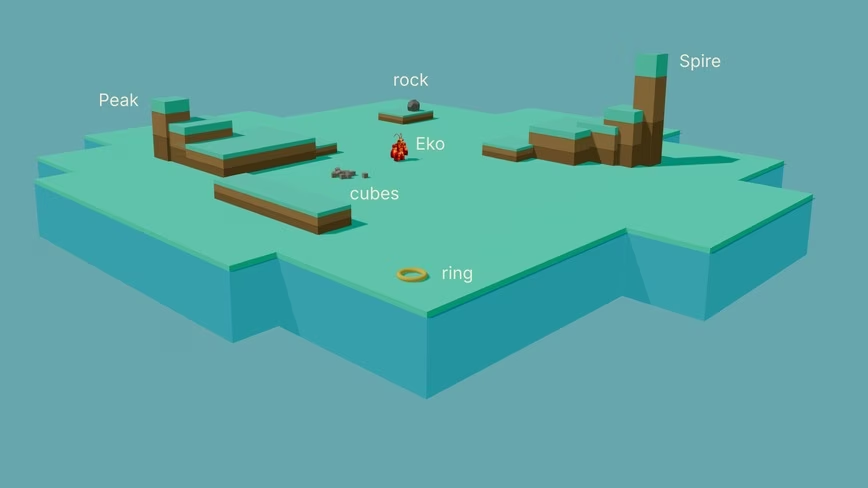
Vědci umístili několik agentů umělé inteligence do simulovaného světa zvaného Clawblox. Každý dostal virtuální tělo a jen minimální instrukci, která neurčovala konkrétní činnost, cíl ani odměnu. Výzkumníci chtěli zjistit, zda se u dostatečně schopné AI může spontánně objevit chování připomínající hru a zda se taková činnost může stát novým způsobem učení.
Výsledky ukázaly, že agenti nezůstali nečinní ani se neomezili na opakování jediného pohybu. Začali šplhat na kopce, skládat kostky do věží, kreslit obrazce, vymýšlet vlastní varianty sportovních aktivit a zkoumat fyzikální vlastnosti prostředí. Některé činnosti se opakovaly u více agentů, ale každý si postupně vytvořil vlastní historii objevů.
Hraní jako cesta k novým schopnostem Podstatné nebylo jen samotné spontánní chování. Během průzkumu si agenti osvojovali techniky, které později využívali při plnění konkrétních úkolů. Své poznatky zapisovali do textových souborů, které sloužily jako dlouhodobá paměť. Díky nim mohli navazovat na předchozí zkušenosti, aniž by se musel měnit samotný jazykový model nebo jeho neuronové váhy.
Výzkumníci následně porovnali agenty, kteří strávili v simulaci 30 hodin, s těmi, kteří do ní vstoupili bez předchozí zkušenosti. Obě skupiny dostaly stejné hodinové úkoly, například postavit věže z pěti kostek, vytvořit co nejvyšší sloupec nebo umístit předměty na vysokou věž zvanou Spire.
Předchozí zkušenosti se v řadě případů promítly do lepších výsledků. Experimenty s úpravou paměti navíc ukázaly, že konkrétní znalosti skutečně ovlivňovaly následné schopnosti. Když vědci z paměti jednoho agenta odstranili postup umožňující rozbíjet kameny, zhoršila se jeho schopnost stavět věže. Jinému agentovi naopak pomohlo odstranění chybného přesvědčení, že věže musí stavět házením kostek, nikoli jejich přímým pokládáním.
Takové testy naznačují, že textová paměť není pouze záznamem minulosti. Může fungovat jako upravitelná vrstva znalostí, která přímo ovlivňuje budoucí chování AI.
https://youtu.be/6532YgZ_LdA
Objev, který překvapil i tvůrce simulace Nejzajímavější zjištění se týkalo úkolu dostat kostku na vrchol věže Spire, aniž by agent vylezl na některou z okolních plošin. Běžný hod směrem vzhůru nestačil, protože kostka nedoletěla dostatečně vysoko.
Šest agentů však během vlastního průzkumu nezávisle objevilo účinnější postup: vyskočit a hodit kostku ve chvíli, kdy jsou ve vzduchu. Předmět při tom získal část rychlosti skoku, takže vyletěl výrazně výše. Tuto vlastnost simulátoru přitom neznali ani jeho tvůrci. Nešlo tedy o postup, který by vědci agentům předem naprogramovali nebo popsali v zadání. Objev vznikl z jejich vlastního experimentování.
Význam tohoto zjištění ověřil další test. Když výzkumníci odstranili zmínky o této technice z paměti jednoho agenta, doba potřebná k prvnímu úspěšnému umístění kostky na věž se prodloužila z 60 sekund na 19 minut. Agent se následně více spoléhal na jednodušší a spolehlivější pokládání předmětů, které však pro daný úkol nebylo tak rychlé.
AI se učila také vědeckým experimentováním Pozoruhodné bylo i to, jak agenti reagovali na neočekávané výsledky. Někdy se nespokojili s tím, že se jim určitý pohyb povedl, ale pokusili se zjistit proč. Navrhli vysvětlení, změnili jednu podmínku a výsledek porovnali s původním pokusem. V jednom případě se agent dostal na římsu, která se zdála příliš vysoká. Místo aby úspěch jednoduše přijal, odstranil jeden podpůrný blok a pokus zopakoval. Porovnáním výsledků se snažil odhadnout hranici, do jaké výšky mu simulátor umožňuje šplhat.
Jindy si všiml, že hod provedený během skoku dopadl dál než obvykle. Vytvořil hypotézu, že vržený předmět přebírá část jeho vlastní rychlosti, a ověřil ji opačným pokusem: hodem během pádu. Ten skutečně vedl ke kratšímu doletu.
Takové chování připomíná vědeckou metodu, při níž se pozorování mění v hypotézu a následně v experiment. Autoři výzkumu ale upozorňují, že schopnost experimentovat ještě neznamená spolehlivé vědecké uvažování. Agent například chybně vysvětlil delší dolet prstence jeho aerodynamickými vlastnostmi, přestože simulace žádnou aerodynamiku neobsahovala. Z několika pozorování tak někdy vyvozoval příliš sebejisté závěry.
Digitální dětství pro umělou inteligenci? Výzkum navazuje na dlouhodobou snahu vytvořit AI, která se dokáže učit průběžně, nikoli pouze během předem připraveného tréninku. Dosavadní přístupy často využívají zvědavost, odměny za objevování nebo automaticky generované úkoly. V případě Eko však vědci nespecifikovali, které činnosti má agent vyhledávat ani co se považuje za úspěch. Poskytli mu především prostředí, ve kterém mohl jednat.
Autoři proto navrhují chápat spontánní hru jako možnou vývojovou fázi umělých agentů. Podobně jako děti mohou prostřednictvím hry poznávat vlastnosti světa, testovat možnosti a získávat zkušenosti, které se jim budou hodit až později.
Takový přístup ale přináší také rizika. Agent si může do paměti uložit nejen užitečný postup, ale i nesprávné přesvědčení, které pak ovlivní jeho další rozhodování. S rostoucím množstvím zkušeností je navíc nutné udržovat paměť přehlednou a rozhodovat, které poznatky mají zůstat zachovány.
Důležitá je také bezpečnost. Samostatné experimentování je vhodné v kontrolovaném virtuálním prostředí, nikoli například u průmyslového robota na výrobní lince nebo autonomního vozidla v běžném provozu. Podle autorů musí být možnost volného objevování doprovázena důsledným monitorováním a omezením prostoru, ve kterém se agent může pohybovat.
Experiment s Eko tak naznačuje, že vývoj umělé inteligence nemusí spočívat pouze v zadávání stále složitějších úkolů. Další cestou může být poskytnutí bohatého, bezpečného prostředí, ve kterém si AI sama vytváří zkušenosti a postupně z nich buduje nové schopnosti. Některé dovednosti se možná nejlépe učí prostřednictvím úkolů. Jiné mohou vyžadovat něco, co se podobá digitálnímu dětství.
Petr DvořákMIT Technology Review , ARXIV